AI + Data Infra:Ray 架构解析
数据湖解决了数据如何持久化、更新和共享的问题,但数据进入计算阶段后,还需要另一套系统:把预处理、模型训练、推理、环境交互和结果写回组织起来,让不同机器上的 CPU、GPU 与内存协同工作。特别是在大模型场景中,一次任务往往不再是一张固定的 SQL 执行图,而是持续创建任务、维护模型进程、交换中间结果,并根据运行结果决定下一步计算。
Ray 从强化学习等动态计算场景起步,用三种抽象描述这类应用:Task 表达一次计算,Actor 保存可跨调用复用的状态,ObjectRef 将上游结果连接到下游任务。本文将沿着一次远程调用,拆解 Ray 如何选择执行节点、传递对象、分配 GPU,以及失败后哪些状态能够恢复;再结合 Ray Data、Train、Serve 和强化学习系统的生产实践,讨论一个架构选型问题:什么时候值得引入 Ray 来组织计算,什么时候直接使用 Kubernetes 作业、训练框架或推理引擎就已足够。
Ray 为什么出现
从批处理作业到动态计算
传统分布式计算通常围绕相对稳定的执行计划展开:输入数据确定后,系统将计算拆成若干阶段,再通过数据分区、并行执行和 Shuffle 完成作业。这个模型非常适合关系查询、大规模 ETL 和聚合分析。
AI 工作负载却经常需要另一种执行方式。以强化学习为例,系统需要同时运行环境模拟、策略推理、奖励计算和模型训练;不同环境的交互轮数、样本长度和结束时间都可能不同,后续任务也可能只有在前一步完成后才能确定。这里的难点不只是数据规模,而是计算本身具有动态性和异构性。
这类应用通常有四个共同要求:
- 任务动态生成:计算图可以在运行时扩展,而不是启动时全部确定。
- 进程长期驻留:模型、连接池和环境状态需要复用,不能每次调用重新初始化。
- 资源异构:CPU 负责解析、检索和环境交互,GPU 负责模型计算,不同阶段需要独立扩缩容。
- 中间结果直接传递:上游结果应成为下游依赖,而不是每一步都先写入外部存储。
Ray 最初由 UC Berkeley 的研究团队提出,2017 年发布论文预印本(也参考 Paper 阅读: Real-Time Machine Learning: The Missing Pieces),2018 年在 OSDI 发表(Ray OSDI 论文)。原始设计便围绕强化学习等新兴 AI 应用,将无状态任务和有状态 Actor 放入同一个分布式执行框架,而不只是提供一个更大的 Python 进程池。
从通用运行时走向大模型基础设施
Ray 近几年的变化,可以理解为三个阶段:
| 阶段 | 主要问题 | 架构重心 |
|---|---|---|
| 早期 Ray Core | 如何表达动态、异构、有状态的分布式计算 | Task、Actor、ObjectRef、调度与对象管理 |
| Ray 2.0 与 AI 库体系 | 如何降低机器学习系统的集成成本 | 数据处理、训练、调参、服务的统一运行基础 |
| 大模型与 Agent 阶段 | 如何组织 GPU 集群上的训练、生成、反馈与工具交互 | 模型常驻、异构流水线、RL 编排、分布式推理与资源复用 |
2022 年发布的 Ray 2.0,通过更完整的 AI 库体系推动了从“分布式编程工具”到“AI 应用运行基础”的转变。近年的社区演进则进一步集中在大模型强化学习、推理服务、GPU 通信和 Kubernetes 部署上。
需要注意,这不是 Ray 对训练框架和推理引擎的替代。PyTorch、JAX、DeepSpeed、Megatron 和 vLLM 仍然负责各自的张量计算与模型执行;Ray 更关注这些计算如何作为进程和任务被启动、放置、连接与恢复。
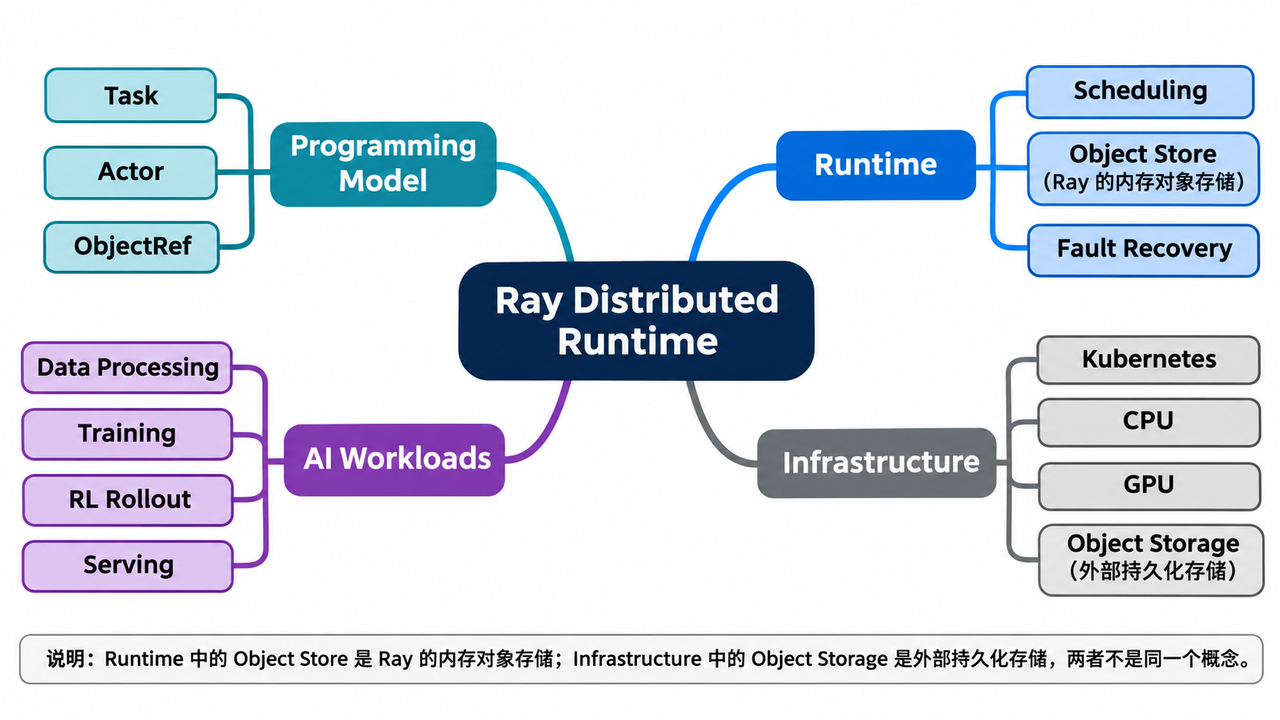
整体概念
理解 Ray,可以围绕四个问题展开:
| 问题 | Ray 的主要抽象 |
|---|---|
| 计算如何表达 | Task 表达一次执行,Actor 表达长期存活的有状态进程 |
| 依赖如何连接 | ObjectRef 连接生产者和消费者,避免 Driver 搬运所有中间数据 |
| 资源如何分配 | 调度器选择执行位置,Placement Group 预留协作进程所需资源 |
| AI 场景如何落地 | Data、Train、Serve 及上层 RL 框架封装具体工作流 |
Ray 的运行时架构
Task、Actor 与 ObjectRef
Ray 的编程模型只有少数几个核心概念,但它们分别解决不同的问题。
| 抽象 | 执行语义 | 典型用途 | 需要注意 |
|---|---|---|---|
| Task | 一次远程函数调用,通常不依赖跨调用的进程状态 | 数据清洗、批量计算、奖励打分 | 失败后可能重试,外部写入需要幂等 |
| Actor | 一个具有身份和内部状态的长期存活进程 | 常驻模型、环境实例、协调器 | 进程状态不等于持久化状态 |
| ObjectRef | 一个远程结果的引用,可以作为后续任务的依赖 | 连接流水线、传递大对象 | 它不是可永久保存的数据地址 |
普通同步 Actor 通常串行执行方法,因此适合封装需要顺序访问的状态;异步 Actor 和多线程 Actor 可以引入并发,但应用需要自己处理共享状态的一致性。
下面是一个省略函数定义的调用示意:
1 | # preprocess、persist 是 Ray Task;model_actor 是已启动的 Actor |
当 ObjectRef 作为顶层参数传入远程调用时,Ray 会将其识别为数据依赖。Driver 不必先执行 ray.get(batch_ref) 再把结果发送给模型进程,从而避免自己成为中间数据的汇聚点。
控制面与数据面
一个典型 Ray 集群包含 Head Node 和多个 Worker Node。这里的“节点”是 Ray 的逻辑运行节点;部署在 Kubernetes 上时,它通常对应一个 Pod,而不是一台 Kubernetes 宿主机。
| 组件 | 主要职责 |
|---|---|
| Driver | 执行应用入口,提交任务、创建 Actor、组织计算依赖 |
| GCS | Global Control Service,管理节点、Actor 等集群控制元数据 |
| Raylet | 每个 Ray 节点上的本地调度与资源管理组件,管理 Worker 和对象相关协调 |
| Worker Process | 执行 Task 或承载 Actor 的语言运行进程 |
| Object Store | 每个节点上的共享内存对象存储,保存需要共享的对象数据 |
| Autoscaler | 根据待满足的逻辑资源需求调整 Ray 节点规模 |
Head Node 通常承载 GCS 等控制组件(Ray 集群核心概念),但不是所有任务的执行入口,也不是所有数据的转发中心。普通任务的分派由调用方、Raylet 和执行 Worker 协同完成;对象数据则可以直接在相关节点之间传输。
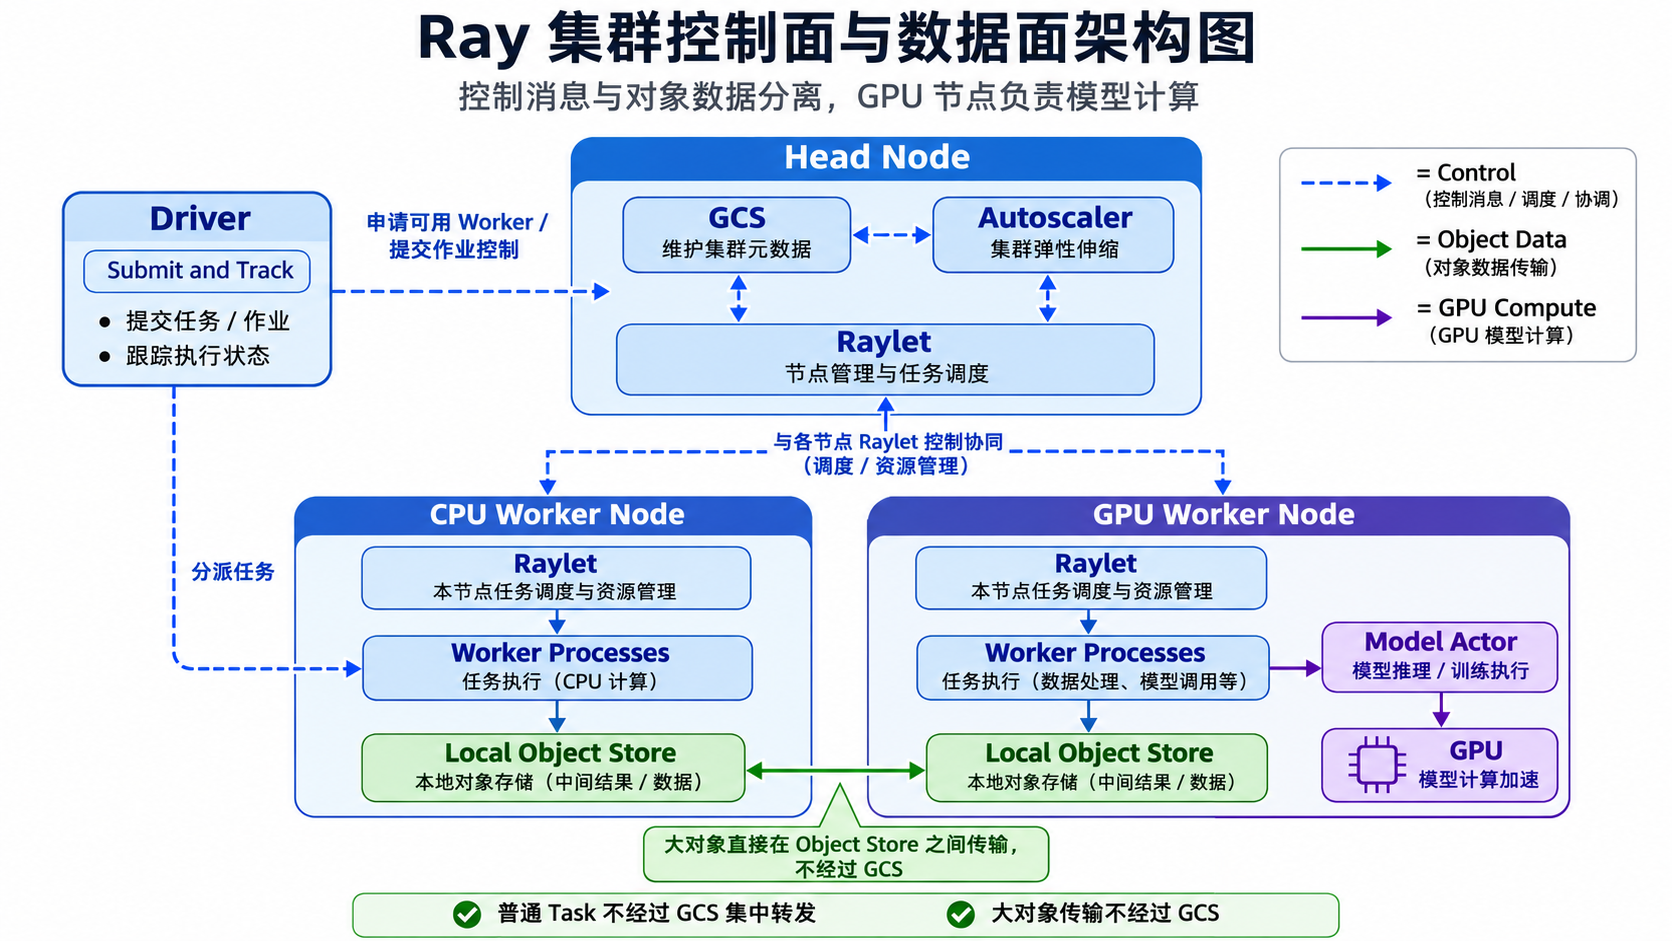
图中有两条路径:蓝色框是控制面,GCS 维护节点和 Actor 等集群元数据;提交普通任务时,调用方通过 Raylet 找到可用的 Worker,再把任务发给它,不必先到 GCS 排队。绿色框是数据面:例如 CPU 节点完成预处理后,如果 GPU 节点需要这一大批样本,数据就从 CPU 节点的对象存储传到 GPU 节点,不需要 Driver 或 GCS 中转。
一次远程调用如何执行
一次普通 Task 调用,可以简化为以下过程:
- 构建任务描述:调用
.remote()后,提交方记录函数、参数、资源要求和依赖,并立即得到 ObjectRef; - 选择执行位置:调用方与 Raylet 协作,根据资源可用性、调度策略和数据位置寻找可执行的 Worker;
- 准备输入:小参数可以随调用直接传输,大对象通常通过对象存储共享;跨节点依赖需要发生真实的数据传输;
- 执行任务:取得 Worker 后,普通任务可以由提交方直接分派给执行进程,而不是让 GCS 转发函数调用;
- 返回结果:小结果可能直接返回,大结果可以存入对象存储,通过引用连接下游任务。
这里有两个重要边界:
- Object Store 不是所有参数和结果的必经路径,小对象可能直接随 RPC 传递;
- ObjectRef 避免的是不必要的汇聚和复制,不是消除网络传输。生产者与消费者不在同一节点时,数据仍然需要跨网络移动。
对象共享与故障恢复
假设 Driver 调用 ref = preprocess.remote(),远端 Worker 生成一个大型 NumPy 数组。数组保存在执行节点的 Object Store 中,Driver 拿到的是 ObjectRef,不是数组本身。同一节点上的其他 Worker 可以直接读取共享内存中的数组,无需各自复制一份;需要修改时,先复制到进程自己的内存。其他节点若没有副本,则需要先传输数据。这里的零拷贝指支持的 NumPy 数组在同一节点上的读取,不是对任意 Python 对象或 GPU Tensor 的保证。
在这个例子里,执行任务的 Worker 生成数据,发起调用的 Driver 才是对象的 Owner。Owner 维护对象位置、引用计数等元数据;将 ref 传给其他 Worker,不会转移所有权。对于 ray.put(value) 创建的对象,Owner 则是调用 ray.put() 的进程(Ray 对象所有权)。
这一区别决定了故障后的行为:丢失数据副本时,只要 Owner 仍在,Ray 会先查找其他副本;如果没有副本,对于可重建的 Task 结果,还可以重新执行任务。ray.put() 没有对应的生产任务,无法靠重算恢复。丢失 Owner 时,即使其他节点暂时还保留数据,也无法接管原引用;后续通过该引用取值会得到 OwnerDiedError(Ray 对象故障恢复)。
Ray 的恢复能力需要按状态类型分别理解:
| 状态或故障 | Ray 提供的机制 | 应用仍需负责 |
|---|---|---|
| 普通 Task 执行失败 | Worker 崩溃等系统故障按 max_retries 重试;业务代码抛出的异常默认不重试 |
区分可重试与不可重试的错误,设置重试上限,保证外部写入幂等 |
普通 Task 结果丢失(batch_ref) |
先查找其他副本;若全部丢失,且 Owner 存活、任务及其依赖可重建、仍有重试额度,Ray 可重新执行 preprocess() |
保证输入可恢复,重复执行不会产生错误结果或重复写入 |
Actor 方法结果丢失(result_ref) |
即使 Actor 仍在,所有副本丢失后也默认不会重放 predict();允许方法重试需配置 max_task_retries |
确认方法可安全重放,且重放时使用正确的模型版本和状态 |
| Actor 进程崩溃 | 按 max_restarts 配置重启并重新执行 __init__(),不会自动恢复崩溃前的内存状态 |
从 Checkpoint 或外部存储恢复模型、业务状态和处理进度 |
| Object Store 内存不足 | 可将部分对象临时溢写到磁盘等介质,按需读回;溢写不等于持久化备份 | 控制在途数据量,分别监控对象存储、Worker 堆内存和 GPU 显存 |
| 对象的 Owner 进程退出 | 其他进程不能接管原 ObjectRef;后续通过原引用取值会收到 OwnerDiedError |
从持久化数据恢复,或重新提交计算以获取新引用 |
| Driver 进程退出 | 重新启动 Driver 不会从原 Python 执行位置继续;若 Driver 也是某个对象的 Owner,该对象的原引用随之失效 | 持久化作业进度和提交记录,重启后从最近的恢复点继续,避免重复提交 |
Actor 重启不等于状态恢复,也不等于方法重试。 max_restarts 控制 Actor 崩溃后是否重启。重启时,Ray 会重新执行 __init__(),不会还原原有的 Python 内存状态;要接着上次的训练步数或处理进度继续,应用必须事先保存 Checkpoint,并在重启后加载。max_task_retries 则控制方法调用在系统故障后是否重试。若 Actor 已写入数据库,却在返回成功前崩溃,重试可能再次写入,因此写入端应使用稳定的业务键保证幂等(Ray Actor 故障恢复)。
Object Spilling 缓解的是对象存储的内存压力,不是作业恢复问题。 当共享内存紧张时,Ray 可以把部分对象暂时写到磁盘,后续访问时再读回。即使对象已经落盘,也不能据此判断训练完成了哪一步、哪批结果已成功写入:前者需要 Checkpoint,后者需要业务提交记录(Ray Object Spilling)。
GPU 调度与 Placement Group
假设一个训练作业需要 16 个 Worker,每个占用 1 张 GPU。前 8 个 Worker 即使已经拿到卡,也得等其余 8 个就绪后才能开始集体通信。Ray 的 Placement Group 解决的就是这个问题:先为整组 Worker 预留资源,再把它们调度到约定的位置。
这里预留的是逻辑资源。num_cpus=2 表示调度时计入 2 个 CPU,并不限制进程只能创建两个线程;num_gpus=0.5 允许多个 Worker 共享一张 GPU,并不会为每个 Worker 划出一半显存。Ray 可以通过 CUDA_VISIBLE_DEVICES 指定 Worker 可见的 GPU(Ray 资源模型)。
如果要求这 16 个 Worker 按 8 + 8 放在两个不同的 Ray 节点上,可以把资源需求写成两个 Bundle:
1 | from ray.util.placement_group import placement_group |
每个 Bundle 都必须完整放入一个节点,STRICT_SPREAD 则要求两个 Bundle 落在不同节点。因此,即使集群共有 16 张空闲 GPU,如果分布在 4 个节点上、每个节点只有 4 张,这个组也无法就绪。初始预留是原子的:Ray 不会先占住一个 Bundle,再等待另一个。组就绪后,应用或上层训练框架仍需将 Worker 调度到相应的 Bundle;创建 Placement Group 本身不会启动训练进程(Ray Placement Group)。
生产中还要区分两层保证:放置位置上,KubeRay 中的 Ray 节点通常对应 Pod,两个不同的 Pod 未必位于不同宿主机;如果必须跨宿主机或故障域,还需配置 Kubernetes 的 Pod 反亲和性或拓扑约束。执行语义上,成组预留不等于进程同时启动,更不等于失败时整组回滚;训练进程如何会合、建立通信组,以及从哪个 Checkpoint 恢复,仍由训练框架和应用负责(Kubernetes Pod 放置约束)。
大模型场景如何使用 Ray
数据处理与批量推理
一个常见场景是:读取数据湖中的文本或图片,执行解析、过滤和 Tokenization,再调用模型生成 Embedding、质量分数或合成数据,最后将结果写回数据湖。这类任务面临的问题通常不是某一个算子太慢,而是不同阶段的资源需求不一致:
- 数据读取、解码和 Tokenization 主要消耗 CPU、内存与存储带宽。
- 模型推理需要 GPU,且模型初始化成本高,适合长期驻留。
- 输出序列化与写回又回到 CPU 和存储路径。
Ray Data 将数据拆分为 Block,通过流式执行在算子之间传递。CPU 处理可以使用 Task,模型推理可以使用 Actor Pool,让每个 Actor 初始化一次模型并连续处理多个 Batch。执行器通过资源预算与反压控制上下游速度,避免 CPU 生产的数据无限堆积在 GPU 前面(Ray Data 内部架构)。
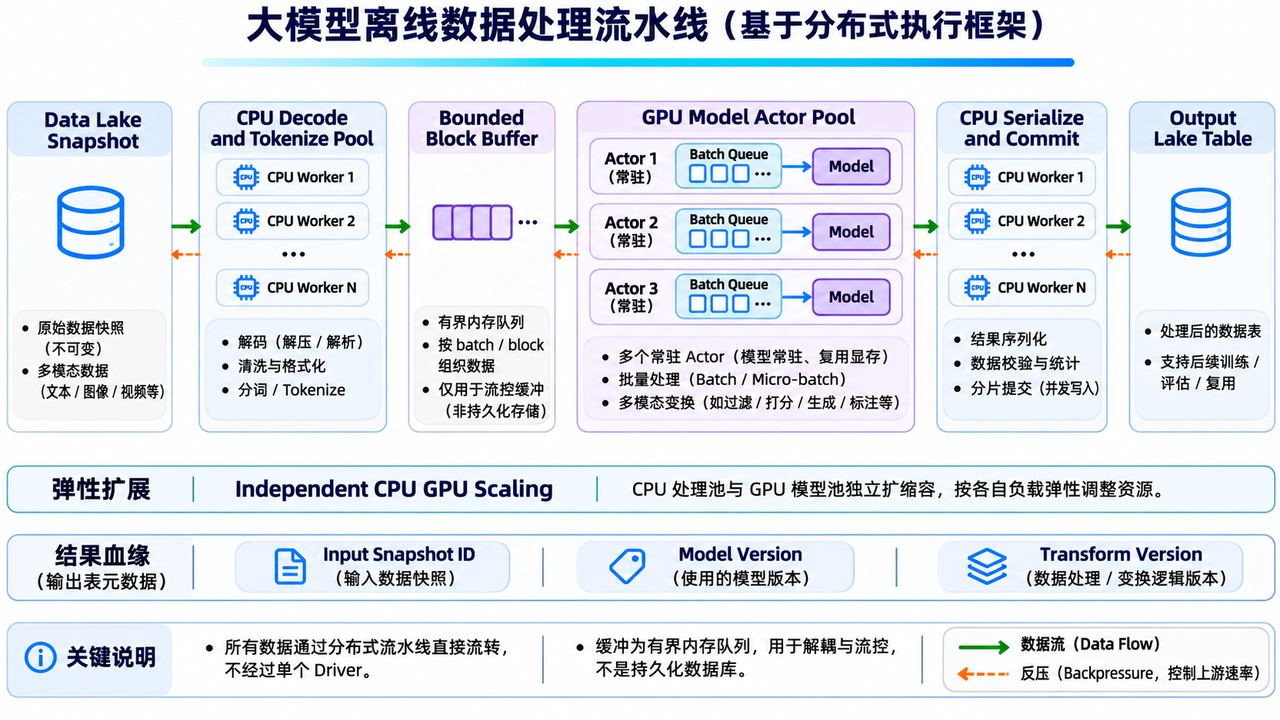
生产设计需要抓住四点:
- 模型只初始化一次:使用常驻 Actor 承载模型,而不是为每个 Batch 重新加载权重;
- 计算粒度足够大:一次任务处理一个 Batch 或数据分片,不要为每一行、每个 Token 创建远程任务;
- 控制在途数据:同时监控 Object Store、Worker Heap 和 GPU 显存,不能只看 GPU 利用率;
- 写回要保证原子提交和幂等重试:记录输入快照、模型版本和处理逻辑版本,便于追溯;通过湖表事务,让同一批结果一次性可见。以 Delta Lake 为例,数据处理可以并行,但写入同一张表时,每条独立写入流应使用各自稳定的
txnAppId,按txnVersion递增顺序提交批次,避免旧批次因晚到而被忽略。若提交成功但回执丢失,重试时复用原批次的两个标识,避免重复追加。
Pinterest 的公开实践展示了这一模式(Pinterest Ray 批量推理实践/Pinterest 多模态购物数据流水线):通过 Ray 将 CPU 数据处理与 GPU 模型推理组合起来,并在多模态购物场景中使用 CPU 预处理和 GPU 模型处理流水线。其价值来自异构阶段的组织与资源利用,而不是 Ray 自动加速了模型算子。
与其他系统相比,场景选型时主要取决于计算场景需求:
| 系统 | 更适合的工作负载 | 相对 Ray Data 的取舍 |
|---|---|---|
| Spark | SQL、Join、聚合、成熟数仓 ETL | 关系执行与生态成熟;复杂模型 Actor 和异构应用编排需要额外集成 |
| Daft | 多模态 DataFrame、表达式计算、AI 数据处理 | 提供更高层的数据执行引擎;可以使用 Ray 作为分布式运行基础,并非与 Ray Core 二选一 |
| Dask | NumPy、Pandas 风格的科学计算与数据分析 | 易衔接 Python 科学计算生态;Ray 的 Actor 和 AI 库体系更适合另一类应用组织方式 |
| Ray Data | Python 模型处理、CPU/GPU 流水线、批量推理 | 与 Ray Actor、Train、Serve 衔接自然,但不能因此假定其 SQL 或 Shuffle 能力全面优于专用引擎 |
Dask 可以通过 Futures 动态提交任务,不限于静态 DAG。Daft 与 Ray Data 同属数据处理引擎;Ray Core 则是 Daft 可以使用的分布式运行时。
Ray Data 的流式执行指算子之间按批次流水处理:CPU 解码完一批图片,GPU 就能开始推理。它描述的是执行方式,并不等同于 Flink 对无界流的事件时间、Watermark 和 Checkpoint 一致性保证。
分布式训练
大模型训练至少有两个不同的调度层次:
- 应用层:需要多少训练进程,放在哪些节点,如何启动、失败后如何恢复;
- 张量层:梯度如何 AllReduce,参数如何分片,流水线阶段如何交换 Activation。
Ray Train 主要负责前者,并集成训练框架完成进程组初始化、指标汇报和 Checkpoint 管理。真正执行 DDP、FSDP、ZeRO、张量并行和流水线并行的,仍然是 PyTorch、DeepSpeed、Megatron 或 JAX 等框架。一个典型设计是:
1 | 训练协调器 |
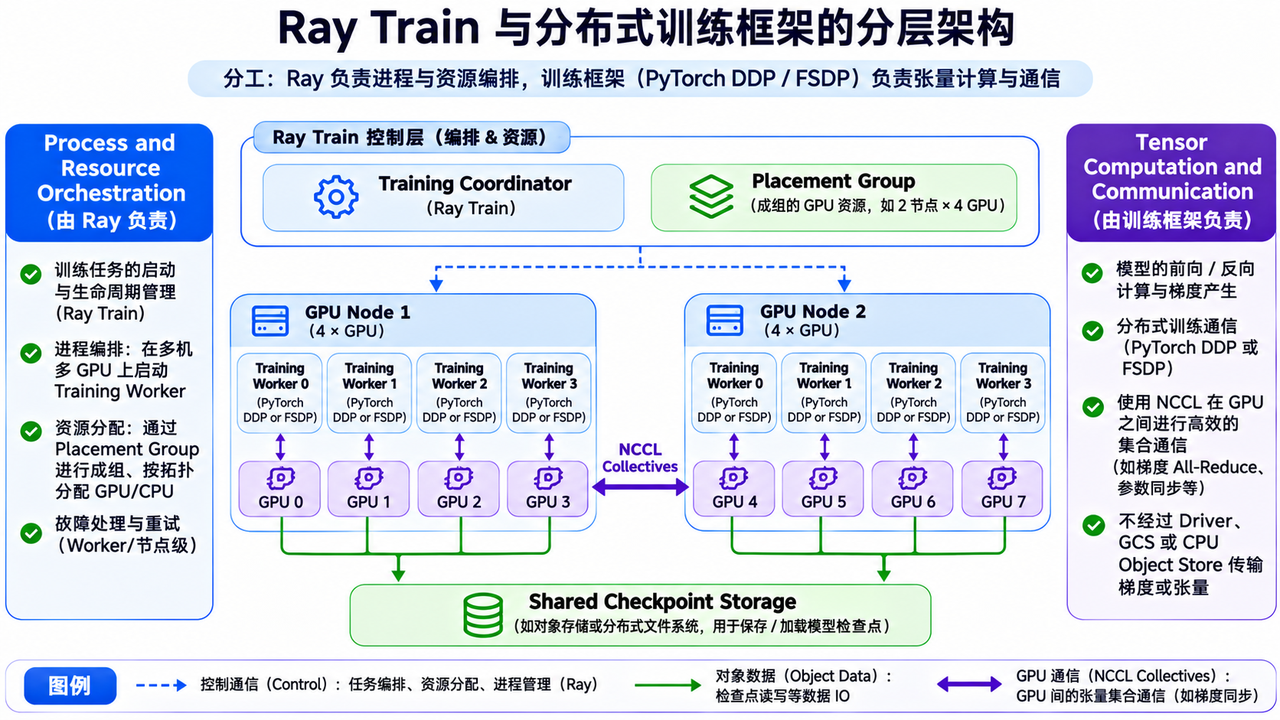
以两台机器、每台 4 张 NVIDIA GPU 的 PyTorch DDP 训练为例。读图时可以沿三条路径来看:Ray Train 负责把训练进程启动在哪里,PyTorch DDP 负责每一步如何计算和同步梯度,持久化 Checkpoint 决定故障后从哪里继续。
- 启动 Worker:先预留资源,再建立通信组。 Ray Train 通过 Placement Group 为 8 个训练 Worker 成组预留资源,每个 Worker 使用 1 张 GPU。资源就绪后,Ray Train 启动 Worker,并协助初始化 PyTorch 分布式进程组。此时解决的是“哪些进程参加训练、各自使用哪张卡”,还没有发生梯度交换;
- 执行训练:每张卡处理不同样本,Worker 之间同步梯度。 在这个 DDP 示例中,8 张卡各自保存一份完整的模型副本。每一步,各 Worker 用不同的样本计算本地梯度;反向传播时,DDP 通常通过 NCCL 的 AllReduce 汇总梯度,各 Worker 再用同步后的梯度更新自己的模型副本。梯度不经过 GCS、Ray Train 协调器或 Ray Object Store:Ray 管理训练进程,张量通信由训练框架完成(Ray Train:GPU 与通信后端);
- 故障恢复:重启的是进程,恢复的是训练状态。 训练代码定期保存模型参数、优化器状态和训练步数,将 Checkpoint 上报给 Ray Train,并持久化到 S3 或共享文件系统。启用故障重试后,Ray Train 可以重启 Worker 组;训练代码仍需加载最近一次成功保存的 Checkpoint,才能从对应步数继续。
ObjectRef引用的是运行时对象,不能替代跨作业重启使用的 Checkpoint(Ray Train:故障恢复)。
Cohere 在 Ray Summit 2022 分享的训练系统体现了同样的分工:Ray 在多个 TPU 主机上分发任务,每个 Worker 将自己的 Batch 分片交给 JAX,在 TPU v4 上执行分布式训练步骤。Cohere 的 Ray 与 JAX 实践 如果只有一个固定规模的 PyTorch 作业,Slurm 或 Kubernetes Job 配合 torchrun 往往更直接;当训练还要衔接数据预处理、评估或多模型协作时,Ray 的价值在于把这些阶段组织起来,而不是加速单个通信算子。
强化学习与 Agent Rollout
在大模型强化学习中,Rollout 是用当前策略生成训练样本的过程。普通问答可能只需生成一次回答;Agent 则可能多次调用工具,根据返回结果决定下一步。模型的动作与环境返回的观测,共同构成一条交互轨迹。
一次策略迭代可以分为三步:
- 生成轨迹:Rollout Worker 接收 Prompt,调用推理引擎生成回答或动作。例如,代码 Agent 可以运行测试,读取报错,再修改代码,直到任务结束;
- 评估轨迹:验证器可以根据测试是否通过给出奖励,也可以由 Reward Model 评分。是否还需要参考策略的对数概率或 Critic 的价值估计,取决于训练算法;
- 更新策略:Training Worker 用这批轨迹和奖励更新模型,再将新权重同步给推理引擎,供后续采样使用。
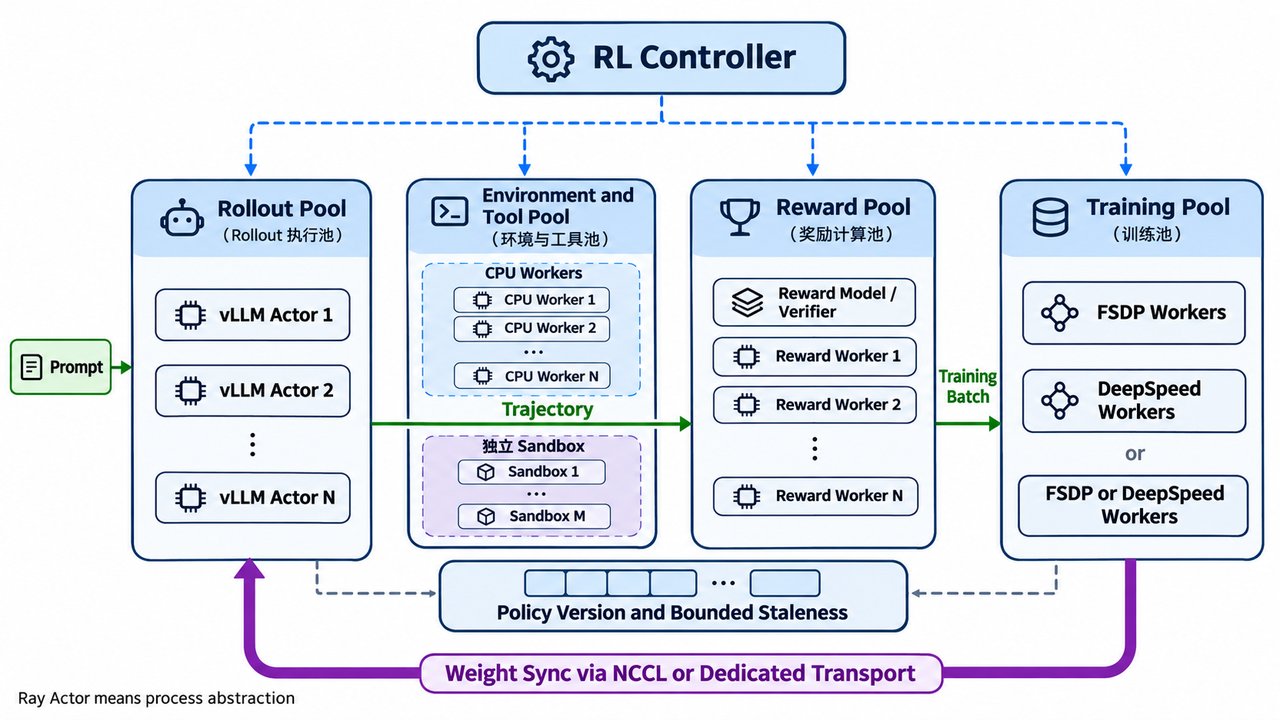
Ray 的价值在于,让耗时和资源需求不同的阶段可以分别组织。工具执行可能主要等待 CPU 或网络,生成和训练则使用 GPU,但不必采用相同的并行策略。以 verl 的 HybridFlow 为例,上层控制器决定何时采样、评分和训练,底层 Worker 组执行模型计算;Ray Actor 让这些 Worker 可以常驻,不必每轮重新加载模型。
生产部署通常在 GPU 复用和流水线吞吐之间取舍:生成与训练可以分阶段共用一组 GPU,代价是两个阶段需要相互等待;也可以拆成独立资源池,在训练上一批样本时生成下一批。后一种方式减少了等待,但样本可能来自较旧的策略,因此需要跟踪采样时的策略版本,并限制队列深度,避免训练长期消费滞后样本。
在线推理与模型组合
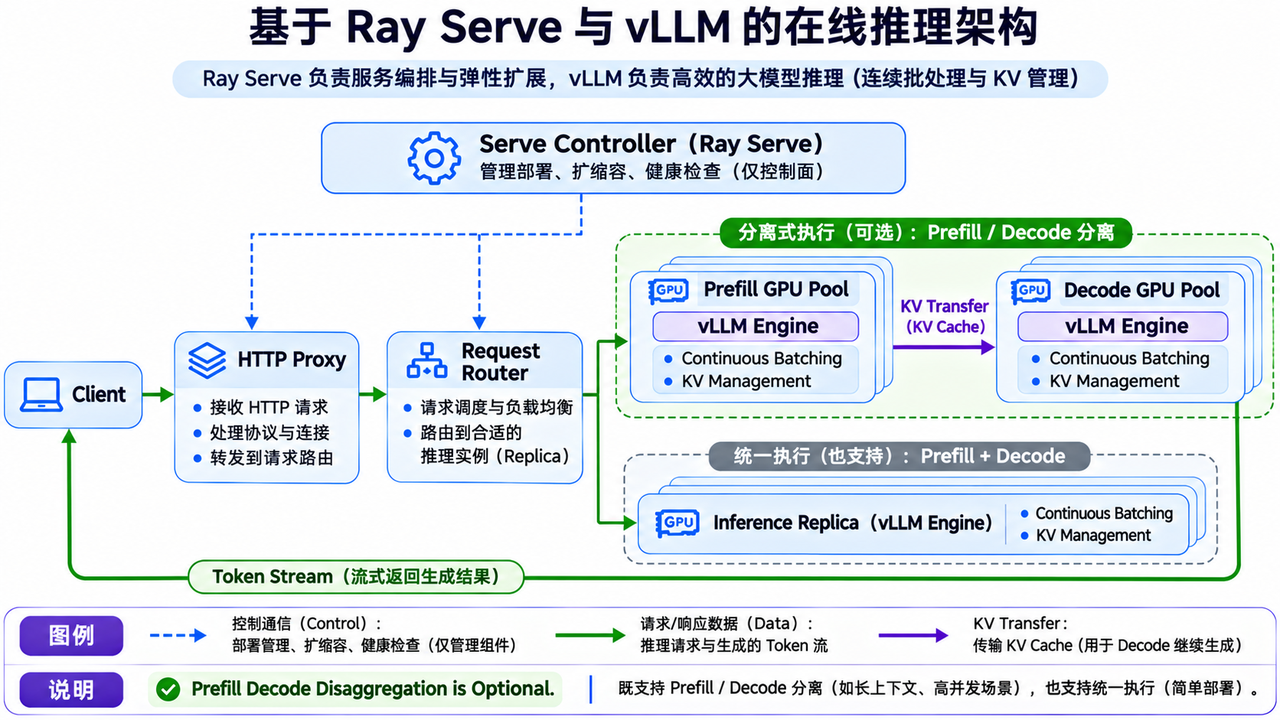
一次检索问答请求,并不是把用户问题直接交给大模型。系统先要找到相关文档,从中选出最有用的片段,再把问题和证据一起交给模型生成答案。这里有两层分工:Ray Serve 负责把多个服务串成一条请求链路,vLLM 负责执行其中的模型生成。
具体来说,Serve Proxy 将请求路由到入口副本;入口副本先调用检索服务取得候选文档,再调用重排副本筛选片段、组装提示词,最后调用生成副本,流式返回答案。将这些阶段拆成独立部署的价值在于按瓶颈扩容:如果请求主要在重排阶段排队,就增加重排副本,不必同时复制占用更多 GPU 的生成模型。反过来,如果业务只需调用一个模型,也没有组合多个服务的需求,直接部署 vLLM 通常更简单(Ray Serve:模型组合)。
再放大链路中的最后一站:生成副本如何使用 GPU? Prefill 处理输入提示词并建立 KV Cache,Decode 复用这份缓存,逐个生成后续 Token。两者可以在同一推理实例中完成,也可以分到不同的 GPU 池独立扩容。分离部署能减少长输入对正在生成的请求的干扰,但也需要跨实例传输 KV Cache。是否值得拆分,应在真实负载下同时比较首个 Token 延迟(TTFT)和后续 Token 的输出间隔(ITL),而不是默认分离就更快(vLLM:Prefill 与 Decode 分离)。
总结
Ray 解决的是如何让一组相互依赖的计算,在集群上协同运行。Task 表达可调度的工作,Actor 保留跨调用的进程状态,ObjectRef 表达任务之间的数据依赖。借助这些抽象,应用可以把 CPU 数据处理、GPU 推理、奖励评估和模型训练组织成一条流水线,而具体的模型运算仍由训练或推理引擎完成。
设计这类系统时,先厘清三个问题,再选择 Ray API:谁负责调度、数据走哪条路径、故障后从哪里恢复? Ray 负责调度任务和放置 Worker,但不同类型的数据不必经过同一条路径:预处理任务可以用 ObjectRef 把中间结果交给下游;在前文的 NVIDIA GPU + PyTorch DDP 示例中,Worker 之间通常通过 NCCL 同步梯度,不经过 Ray Object Store。至于作业重启后仍需保留的模型参数和优化器状态,则应写入持久化 Checkpoint。重新启动 Worker 只能恢复计算进程,加载 Checkpoint 才能接着上次的进度训练。
从 AI 与数据基础设施的分工看,数据湖保存可共享、可追溯的数据,Ray 协调围绕数据展开的计算,训练和推理引擎负责高效执行模型。检验这套架构是否合理,可以看一次具体的故障:当某个节点退出时,系统是否知道哪些任务可以重算、哪些结果已经提交,以及应该从哪里继续执行。