DeepSeek-R1:推理能力如何炼成
2025 年 1 月 20 日,DeepSeek 发布 R1,将高水平推理能力、开放权重和可直接使用的产品入口带到了一起。它受到关注,不只是因为模型能够输出更长的思考过程,更因为开发者终于可以下载、部署和研究一个具有较强推理能力的模型,并基于它训练自己的小模型(官方发布公告)。
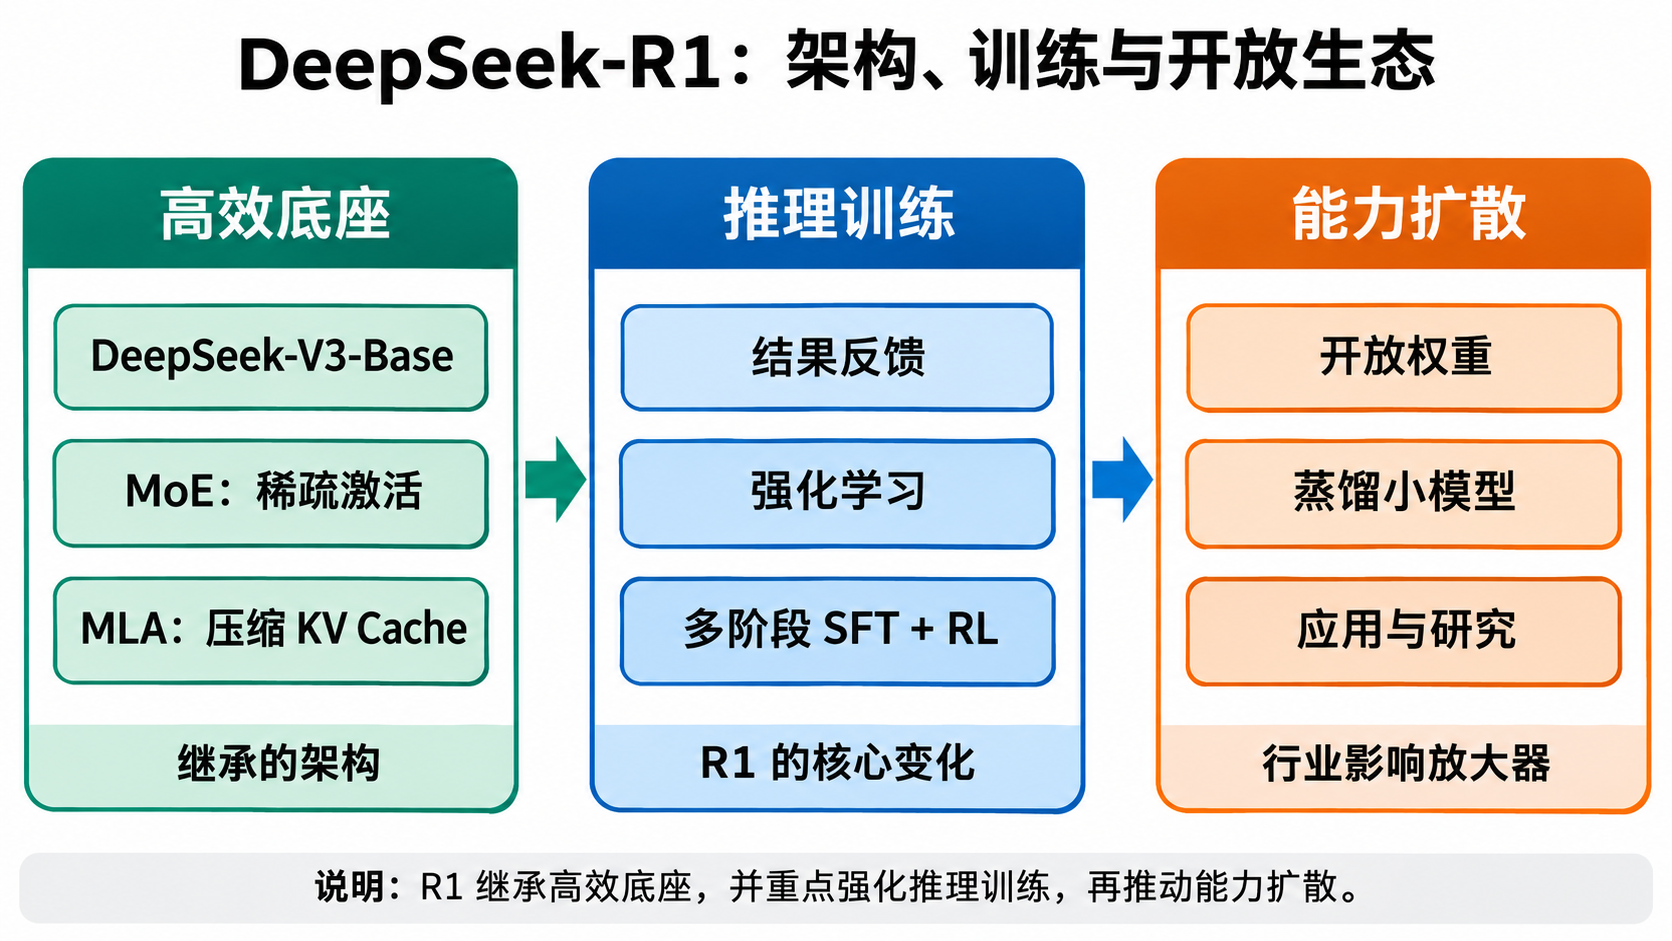
理解 R1,首先要分清两件事:模型架构决定计算如何发生,训练方法决定模型学会怎样利用这些计算。 R1 延续了 DeepSeek-V3-Base 的主体结构,主要突破发生在后训练阶段。MoE 与 MLA 提供了高效底座,强化学习、多阶段训练和蒸馏则把底座转化为推理模型及其衍生生态。
本文聚焦 2025 年 1 月首发版 DeepSeek-R1,以当时的论文和发布资料为依据,不混入 R1-0528 等后续版本的改进。
背景:从生成答案到学习解题
为什么已有大模型还需要推理训练
预训练通过预测下一个 Token,让模型学习语言、知识和大量问题的解法;监督微调(SFT)通过示范答案,让模型更好地遵循指令。但在数学证明、复杂代码和多约束问题中,模型还需要连续完成拆解、计算、检查和修正。
这类任务的困难在于:局部文本合理,不代表整条推导正确。一道题的中间步骤即使很流畅,也可能遗漏条件;一段程序即使语法正确,也可能无法通过边界测试。
思维链(Chain of Thought,CoT)让模型在给出最终答案之前,先生成中间推导步骤,从而逐步完成复杂问题的求解。思维链提示方法由 Jason Wei 等人在 2022 年的论文 《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》中系统提出:在提示词中提供包含推导过程的示例,可以提升模型的推理表现。2024 年,OpenAI 发布的 o1 进一步通过强化学习训练模型的推理能力,并展示了在推理阶段投入更多计算、生成更充分的推导过程,能够改善复杂任务的求解表现。
- R1 面对的核心问题是:能否利用可检查的任务结果,训练模型生成更有效的解题过程,并把这种能力开放给更多人?
这里的变化不只是让模型多输出一些文字,而是改变训练信号:除了模仿示范,还要根据最终结果,对模型自己生成的解法给予反馈。
R1 的创新究竟在哪里
这里可以把 R1 拆成三个层次:
| 层次 | 主要技术 | 解决的问题 | 与 R1 的关系 |
|---|---|---|---|
| 模型结构 | DeepSeekMoE、MLA | 大模型的计算量、KV Cache 与带宽压力 | 主要继承自 V3 及更早工作 |
| 后训练 | R1-Zero 实验、多阶段 SFT 与 RL | 如何训练有效推理,同时保持可读性和通用性 | R1 的核心技术贡献 |
| 能力传播 | 开放权重、推理数据蒸馏、API | 如何让研究者和应用团队使用推理能力 | 放大 R1 行业影响的关键 |
模型架构:V3 为 R1 提供了什么
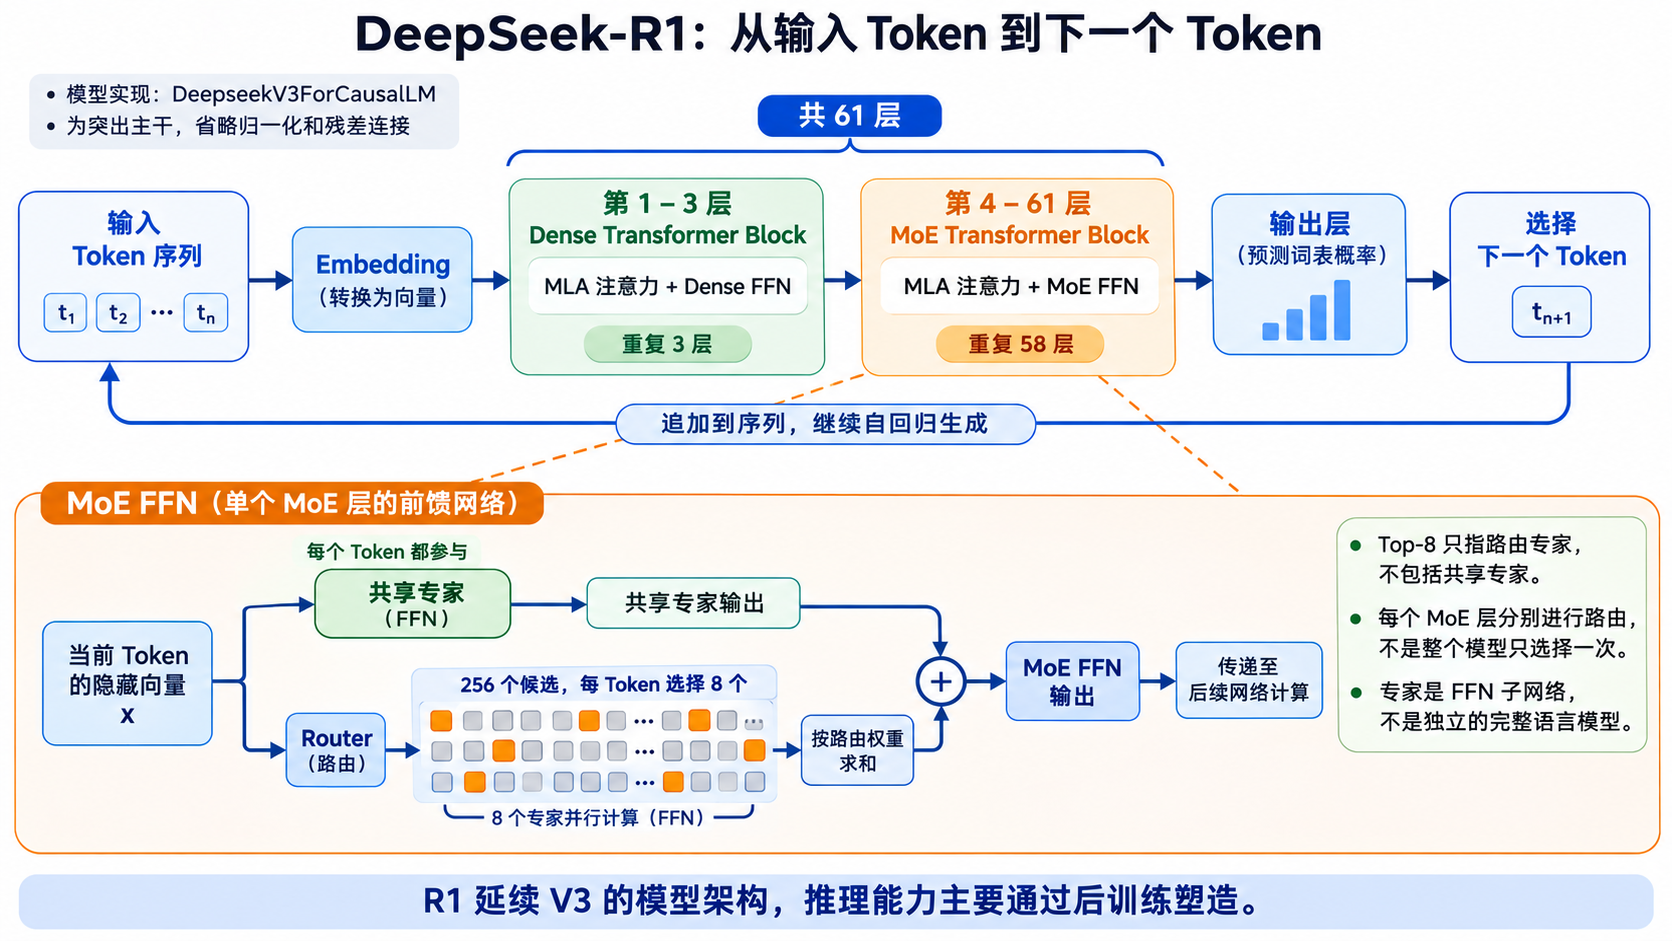
R1 仍然是自回归 Decoder-only Transformer。输入经过 Embedding 和多层 Transformer Block,最后预测下一个 Token。它没有在网络里额外安装一个独立的“逻辑推理引擎”。
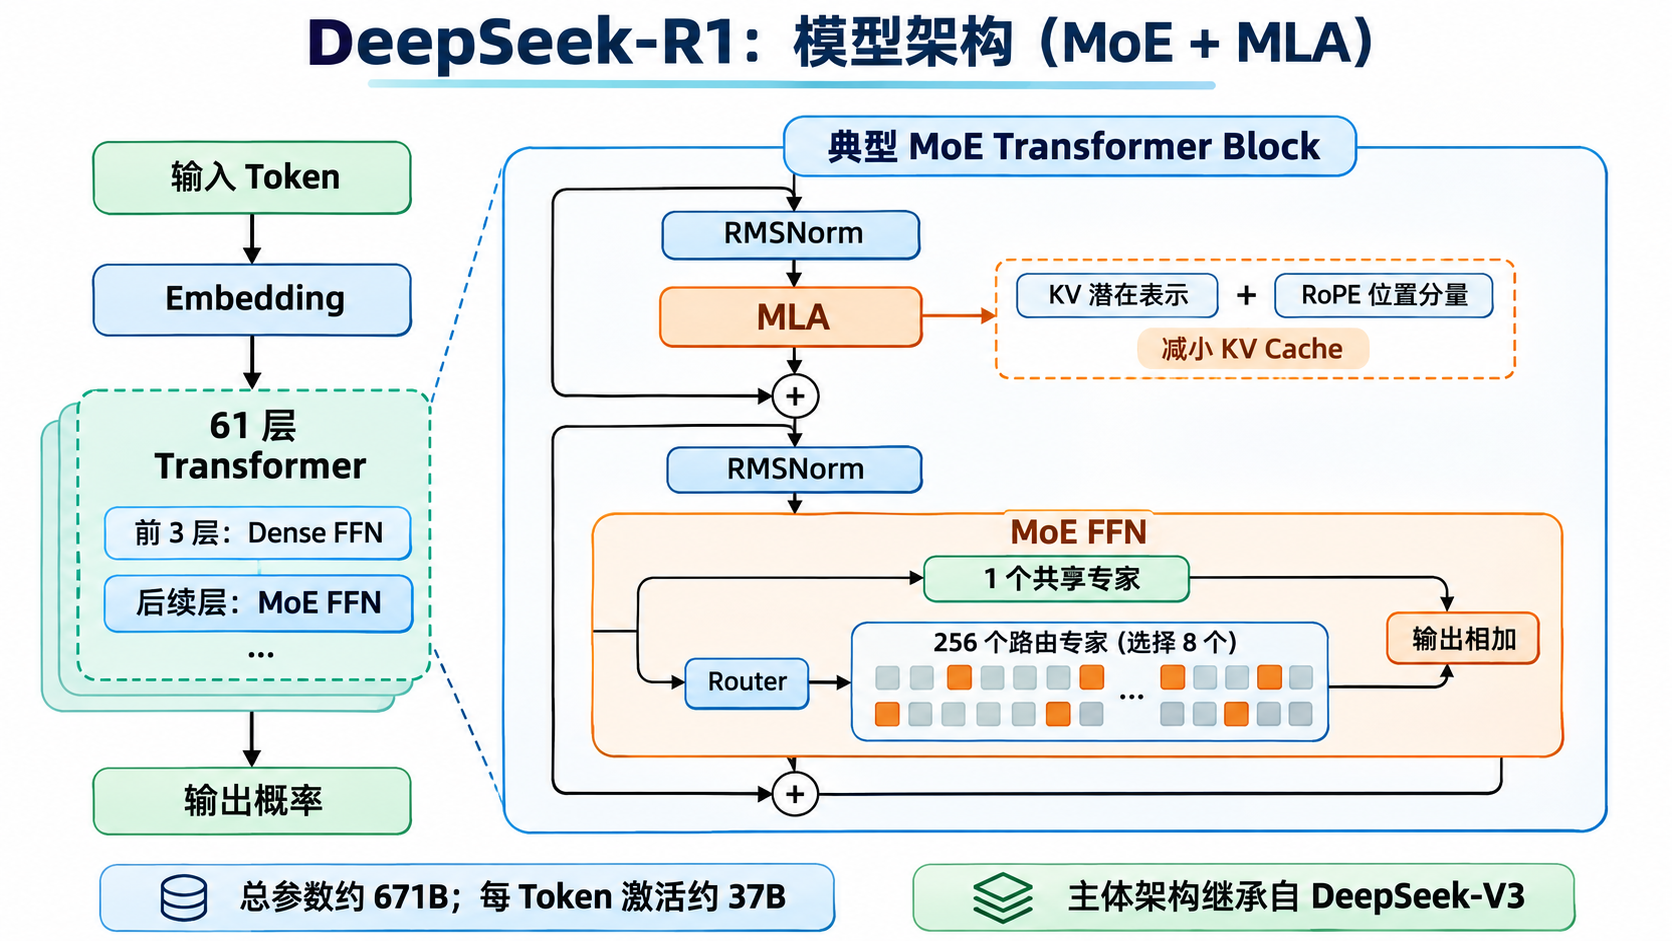
官方配置仍使用 DeepseekV3ForCausalLM。主体有 61 层,前 3 层使用 Dense FFN,后续层使用 MoE;在每个 MoE 层中,有 1 个共享专家和 256 个路由专家,每个 Token 选择其中 8 个路由专家(官方配置文件),如下图所示:
DeepSeekMoE:扩大容量,控制每 Token 的计算
在 Dense FFN 中,每个 Token 的表示都经过同一组完整矩阵。扩大 FFN 宽度会直接增加每个 Token 的计算量。MoE 将这部分计算组织成多个专家网络,由 Router 根据当前 Token 的隐藏状态选择少数专家参与计算。
DeepSeekMoE 有两个关键设计(DeepSeekMoE 论文):细粒度路由专家提供更灵活的组合,共享专家承担共性表示,减少路由专家之间的重复学习。 专家是 FFN 子网络,不是多个完整聊天模型,也不是预先指定的“数学专家”“代码专家”。
忽略残差连接和归一化,一个 MoE 层可以简化为:
1 | 输出 = 共享专家(x) + Σ 路由权重_i × 专家_i(x) |
R1 完整模型约有 671B 总参数,每个 Token 激活约 37B 参数,通过稀疏激活在扩大模型容量的同时控制计算量。但未激活的专家仍需存储,分布式部署也存在通信和调度开销,因此不能按 37B 模型估算其部署成本。为改善专家负载分布,V3 主要通过动态路由偏置实现负载均衡,同时保留轻量的序列级约束,防止单条文本过度集中使用少数专家。
MLA:降低长序列的缓存压力
MLA,全称 Multi-head Latent Attention,多头潜在注意力,通过可学习的低秩投影,把 K/V 的信息联合压缩到较小的潜在表示中。实现时配合矩阵吸收,能够避免在每一步显式恢复全部历史 K/V;位置相关的 RoPE 分量则单独处理和缓存。
自回归生成需要保存历史 Token 的 Key 和 Value。推理过程越长,KV Cache 越大;逐步生成时,还需要不断读取这些历史缓存。
1 | 传统 MHA:缓存各个注意力头的历史 K 和 V |
对 R1 而言,这项继承的架构尤其有价值:更长的解题过程意味着更多生成 Token,压低每个 Token 的缓存成本,可以减轻持续生成时的显存与带宽压力。MLA 降低缓存成本,但不会消除全量注意力随上下文增长的计算开销。
架构效率与推理能力如何配合
V3 底座的效率不仅来自 MoE 和 MLA,还依赖训练目标与分布式系统的协同优化:
- FP8 混合精度训练让适合低精度计算的矩阵运算使用 FP8,同时在数值敏感环节保留更高精度,以兼顾吞吐、显存占用和训练稳定性;
- 计算与通信重叠通过调度,让部分计算与专家间的数据传输同时进行,减少 GPU 等待通信的时间;
- 多 Token 预测(MTP)则在预测下一个 Token 的基础上增加后续 Token 的辅助预测目标,使每段训练文本提供更丰富的监督信号。这些技术分别改善计算效率、硬件利用率和数据利用效率,共同构成 R1 继承的高效底座。
在此基础上,R1 的推理训练让模型学习如何利用更多生成步骤进行问题拆解、验证和修正。两者的配合可以理解为:底座优化每一步计算的成本,后训练提升这些计算对任务求解的价值。 其中,MoE 减少每个 Token 需要执行的 FFN 计算,MLA 降低历史信息的缓存与读取负担,但较低的单 Token 成本并不意味着每次任务都便宜。复杂问题可能产生很长的推理过程,持续占用计算和 KV Cache;实际服务成本还受到并发规模、专家通信和硬件利用率影响。因此,评估 R1 的效率,应结合任务成功率、端到端延迟和单次任务成本,而不能只看“每个 Token 激活 37B 参数”。
训练突破:从 R1-Zero 到 R1
R1-Zero:用结果反馈训练解题行为
R1-Zero 探索了一条直接的训练路线:从已经完成预训练的 V3-Base 出发,跳过前置监督微调,通过大规模强化学习提升推理能力。 这里的“Zero”指没有先用推理示范进行 SFT,而不是从零学习;模型仍依赖预训练获得的知识,以及训练题目、标准答案和验证规则。训练主要使用两类反馈:
- 正确性奖励检查任务是否完成,例如数学题的最终答案是否正确、生成的代码是否通过测试;
- 格式奖励约束推理过程的输出形式。
模型先生成解题过程和答案,系统再根据验证结果计算奖励并更新参数。这使训练能够减少对人工编写完整推导过程的依赖,让模型探索不同解法,而不必逐步模仿一份标准答案。
R1 的论文观察到,随着训练推进,R1-Zero 出现了更长的推导、自我检查和重新尝试等行为,展示了结果反馈对推理表现的促进作用。但它也存在语言混杂、表达不清等问题,说明提高解题正确率与获得良好的交互体验,仍然是不同的优化目标。
结果奖励也有局限:答案正确不代表每一步推导都成立,通过测试也不代表代码不存在缺陷。因此,R1-Zero 的效果既取决于基模能力,也取决于题目质量和验证器的可靠性;模型生成的检查与修正过程,仍需要通过实际结果检验。
GRPO:通过组内比较优化生成策略
在强化学习中,语言模型可以看作一个“策略”:根据题目和已生成的内容,决定下一个 Token 的概率分布。训练的目标,是利用任务奖励调整模型参数,让它更倾向于生成能够正确完成任务的回答。
- PPO(Proximal Policy Optimization,近端策略优化):是一种常见的策略优化算法。在典型的语言模型 PPO 训练中,除了生成回答的策略模型,还需要训练一个 Critic(价值模型),估计当前生成状态下的预期回报。系统根据实际结果相对这一预期的好坏,决定如何调整生成策略,并通过概率比裁剪限制更新幅度;
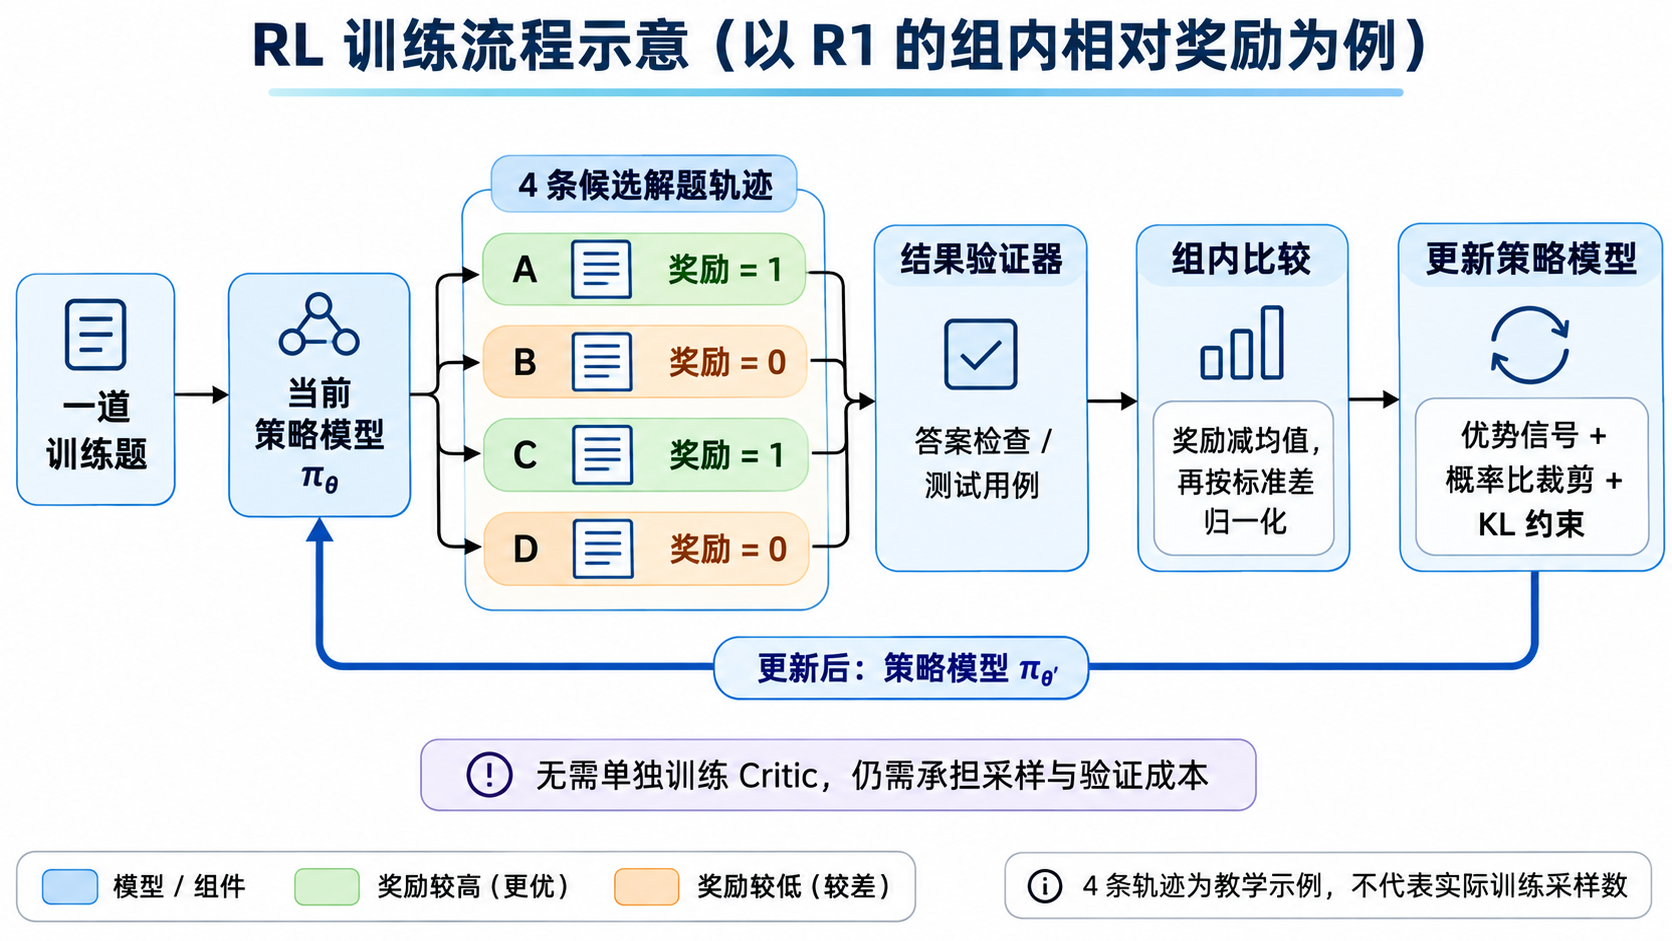
- GRPO(Group Relative Policy Optimization,组相对策略优化):由 2024 年的 DeepSeekMath 论文 提出,后来被 R1 采用。它针对同一道题采样多个回答,用组内奖励统计构造比较基线,从而省去单独训练 Critic 的开销。
| 对比维度 | 典型 PPO 实现 | GRPO |
|---|---|---|
| 比较基线 | Critic 估计的预期回报 | 同一道题多个回答的奖励均值 |
| 优势估计 | 根据奖励与价值估计计算 | 根据组内奖励差异计算并归一化 |
| 是否训练 Critic | 通常需要 | 不需要 |
| 主要开销 | 生成、奖励计算、策略模型与 Critic 训练 | 多回答采样、奖励计算与策略模型训练 |
这里的 Critic 与奖励函数不是一回事:奖励函数评价回答结果,Critic 预测预期回报。GRPO 省去了后者,但仍然需要可靠的奖励。GRPO 中的“优势”,可以理解为一条回答比同组其他尝试好多少:
1 | A_i = (r_i - 组内奖励均值) / (组内奖励标准差 + ε) |
其中,r_i 是第 i 个回答的奖励,ε 用于避免分母为零。假设同一道题生成了四条回答,只按正确性给予奖励:
| 回答 | 奖励 | 相对于均值 0.5 | 奖励项的优化方向 |
|---|---|---|---|
| A:正确 | 1 | 高于平均,优势为正 | 增强该回答的生成倾向 |
| B:错误 | 0 | 低于平均,优势为负 | 减弱该回答的生成倾向 |
| C:正确 | 1 | 高于平均,优势为正 | 增强该回答的生成倾向 |
| D:错误 | 0 | 低于平均,优势为负 | 减弱该回答的生成倾向 |
GRPO 的效果依赖组内比较是否有效:所有回答奖励相同时,该组无法提供相对优劣信号;验证器存在漏洞时,模型可能学会获取奖励,却没有真正完成任务。因此,题目难度、采样多样性和奖励质量都很关键。它减少了 Critic 带来的训练开销,但长回答采样、验证和参数更新仍然需要大量计算。
正式版 R1:探索与示范相互配合
R1-Zero 展示了强化学习的潜力,但可用的助手还需要清晰表达、通用任务能力和行为约束。正式版 R1 因此采用了多阶段方案。
| 阶段 | 做了什么 | 目的 |
|---|---|---|
| 冷启动 SFT | 用少量长推理示范微调 V3-Base | 提供较好的初始表达和解题格式 |
| 推理 RL | 根据结果奖励优化,并兼顾语言一致性 | 提升可验证任务的推理表现 |
| 拒绝采样与 SFT | 筛选推理样本,混合通用样本,重新微调 V3-Base | 把探索结果转为较稳定的监督训练数据 |
| 综合 RL | 结合推理奖励与通用偏好奖励 | 平衡推理、帮助性与安全性 |
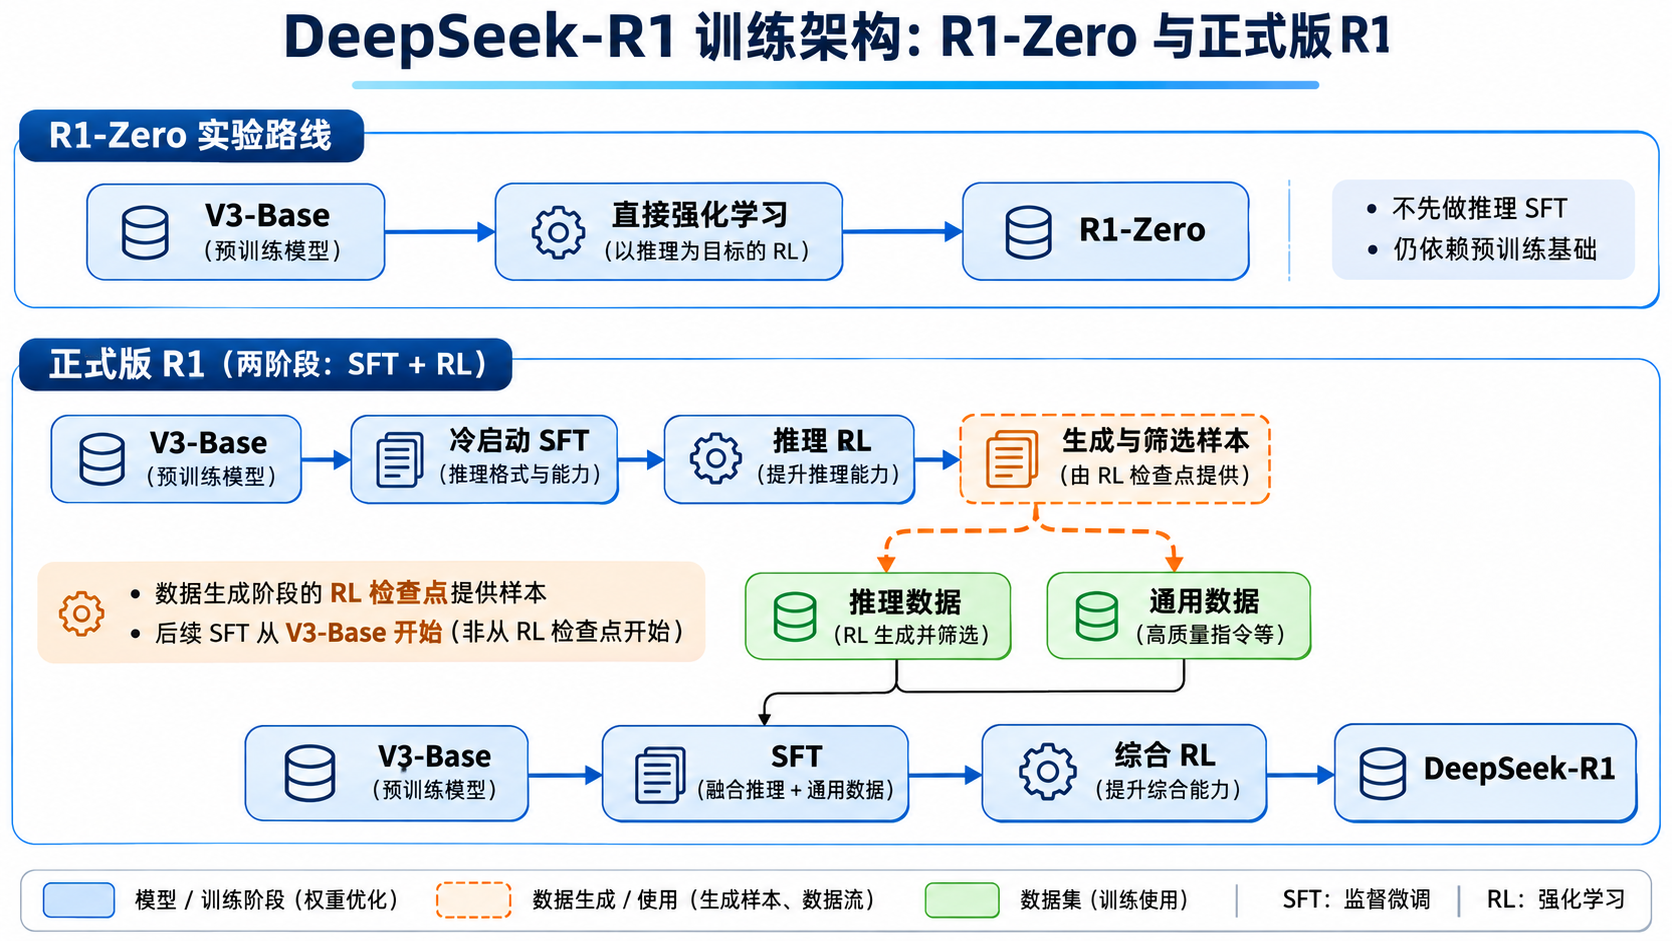
这套训练流程可以理解为:先让模型尝试解题,再把有效的解法整理成示范,用于后续训练。 强化学习让模型根据答案是否正确,调整生成解题过程的方式;筛选环节保留结果正确、表达清晰的样本;SFT 再用这些样本训练模型,使其更稳定地生成高质量的解题过程。这样,模型既能从自己的尝试中获得反馈,也能从筛选后的示范中学习。
完成训练后,模型在回答问题时,会将已经生成的推导步骤作为后续生成的依据,逐步完成计算、检查或修正。这个过程使用的是训练好的固定参数,变化的是当前上下文,而不是模型权重。 更多中间步骤可以为复杂问题提供更充分的求解过程,但也可能延续错误,因此推导更长并不必然意味着答案更准确。
蒸馏:将推理能力传递给小模型
为了降低部署门槛,并验证推理能力能否迁移,R1 系列发布了基于 Qwen 和 Llama 的 6 个 Dense 蒸馏模型,覆盖 1.5B、7B、8B、14B、32B、70B。它们以已有模型的权重为起点,使用 R1 训练流程中整理的约 80 万条推理与通用样本进行 SFT(监督微调),首发版本没有额外进行强化学习(蒸馏训练说明)。
蒸馏传递的是经过筛选的答案与解题过程:学生保留自身的 Dense 架构,通过学习示范调整参数,而不是从完整 R1 中裁剪专家。论文中的 32B 对照实验显示,蒸馏模型在 AIME 2024 上达到 72.6%(对照实验),高于同一底座直接进行大规模 RL 后的 47.0%。这说明,在该实验设置下,学习强模型的解题经验,比让小模型独立探索更有效。
这些模型让更多团队能够在有限资源下使用推理能力,但它们仍受学生模型的容量、知识和泛化能力约束。R1-Distill 提供的是不同成本与能力之间的选择,并非完整 R1 的等价缩小版。
行业影响:为什么 R1 引起了如此大的反响
推理能力进入可下载、可比较的范围
R1 首发评测给出了一个直接信号:开放权重模型已经能在多项推理任务上接近当时的领先闭源模型。
| 首发评测项目 | DeepSeek-V3 | DeepSeek-R1 | OpenAI o1-1217 |
|---|---|---|---|
| AIME 2024,pass@1 | 39.2% | 79.8% | 79.2% |
| MATH-500,pass@1 | 90.2% | 97.3% | 96.4% |
| GPQA Diamond,pass@1 | 59.1% | 71.5% | 75.7% |
| Aider-Polyglot,准确率 | 49.6% | 53.3% | 61.7% |
以上来自 DeepSeek 官方发布的对比表,这些数据支持的是“部分推理任务达到相近水平”,而不是“全面超过 o1”。数学、知识问答和代码编辑之间仍有差异,真实业务还需要检查延迟、输出稳定性和任务成功率。
开放权重让能力能够被研究和扩散
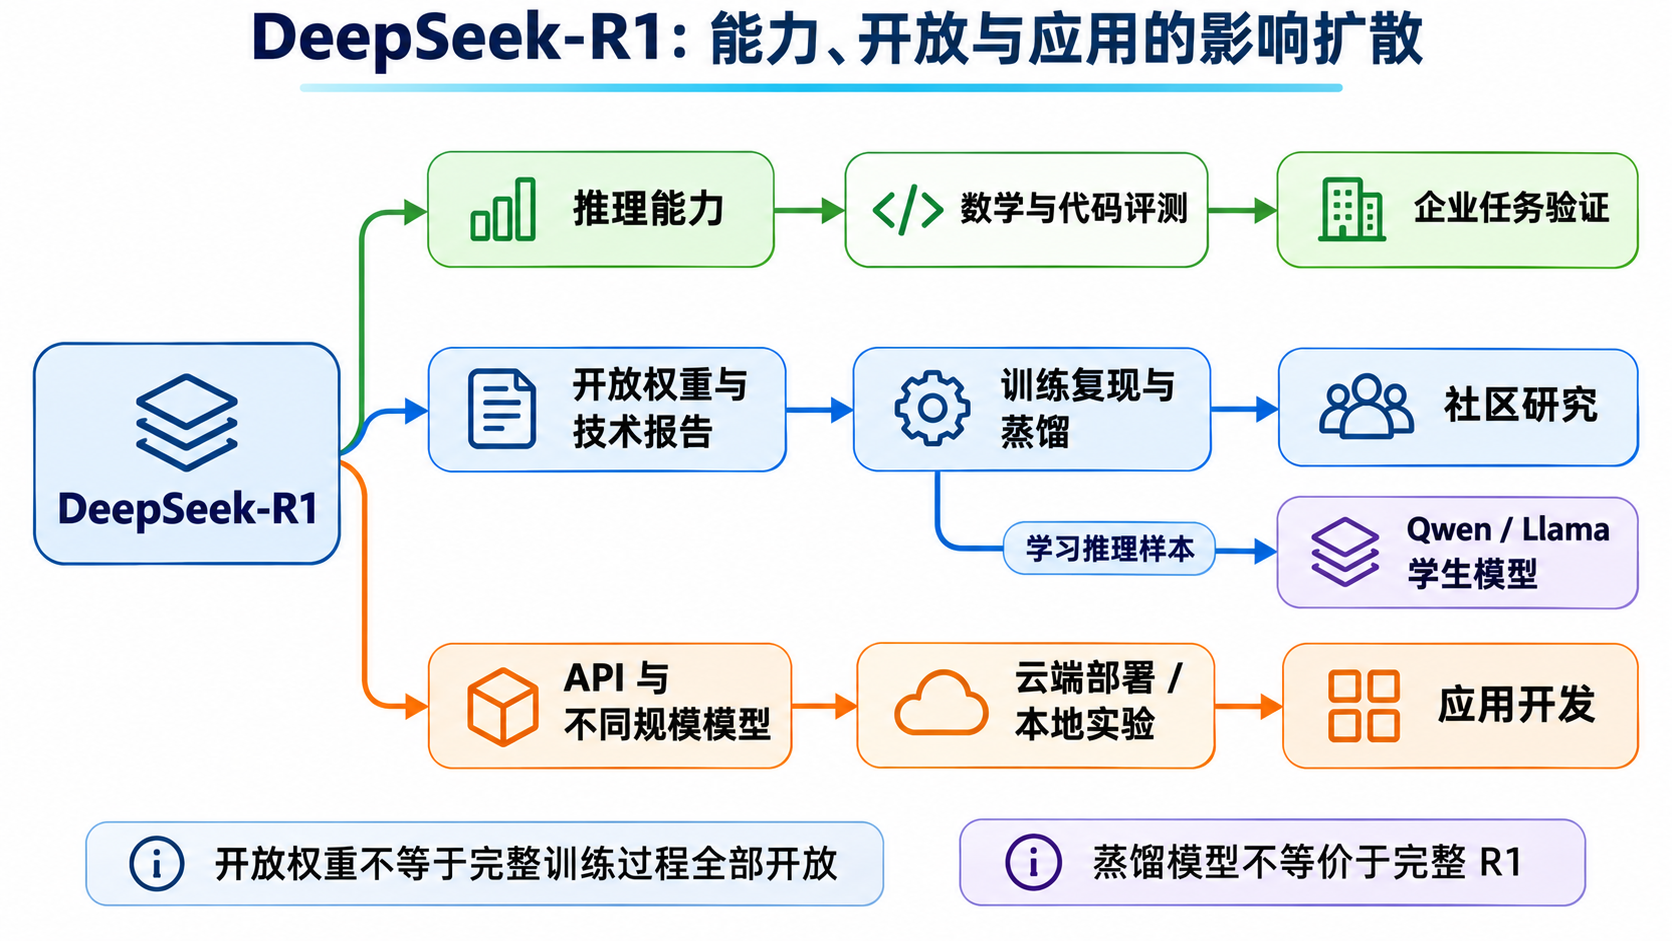
开放权重意味着团队可以自行评测、部署、适配和开展训练实验。配套的小模型又让资源不同的开发者都能参与,而不必全部承担完整模型的部署成本。
R1 官方提供了 MIT 许可,并允许使用输出做蒸馏;具体蒸馏模型还需要结合 Qwen、Llama 等底座的许可条件理解(发布公告/官方许可说明)。
开放的边界也需要说清楚:首发开放了权重和技术路线,但没有同时提供完整训练数据和端到端训练代码。 Hugging Face 在 2025 年 1 月 28 日启动 Open-R1,就是为了补足数据、训练配方和复现环节;次日,微软宣布 R1 进入 Azure AI Foundry 和 GitHub 的模型生态(Open-R1 项目说明/微软接入公告)。
这两类行动体现了不同的扩散路径:研究社区尝试理解和复现方法,产品平台则降低应用接入成本。R1 的影响由此超出了单个模型的榜单成绩。
成本讨论从模型规模转向有效计算
R1 首发 API 定价为每百万输入 Token 0.55 美元(缓存未命中)、每百万输出 Token 2.19 美元,这是 2025 年 1 月的历史价格(首发定价)。这一价格与开放部署选项降低了开发者的使用门槛,但 API 单价并不等于单次任务成本:长推理会增加 Token 消耗,自行部署完整模型也需要较大的基础设施投入。同样,V3 报告中的训练算力成本估算不能代表 R1 的全部研发成本,还需要区分基础模型训练、实验探索、数据处理和 R1 后训练等支出(V3 成本口径)。
从这些技术与发布事实出发,可以将 R1 的影响理解为三方面的叠加:较强的推理表现、可参与的开放生态,以及更受关注的计算效率。 它让更多团队开始研究如何构造可验证任务、设计奖励和筛选推理数据,而不只关注继续扩大参数规模。
总结
DeepSeek-R1 的价值,需要放在当时的技术背景下理解:o1 已经展示了强化学习和推理时计算扩展的潜力,R1 则通过自己的训练方案,在多项推理任务上达到了相近水平。这是能力上的对标,不能直接等同于对 o1 训练方法的复现。
R1 的贡献主要体现在已有技术的有效组合与规模化验证:MoE 和 MLA 提供高效底座,R1-Zero 探索直接通过强化学习改善推理行为,正式版再通过多阶段训练兼顾推理能力与可用性。它表明,强预训练模型之外,任务设计、奖励反馈和数据质量同样能够显著影响模型表现。
开放则进一步放大了这次技术实践的影响。 权重、技术报告和蒸馏模型,让接近当时领先水平的推理能力进入可部署、可检验、可继续研究的开放生态。虽然首发没有公开完整训练数据和端到端训练代码,但它为更多团队提供了参与的基础。R1 留下的重要启示是:模型发展的竞争不仅在于能力上限,也在于能否让这些能力以可接受的成本被广泛使用和持续改进。
主要参考资料
- DeepSeek-R1 原始论文,2025 年 1 月版本:R1-Zero、正式版训练流程与蒸馏。
- DeepSeek-R1 官方仓库:模型规格、评测与许可。
- DeepSeek-V3 技术报告:R1 继承的模型底座及训练工程。
- DeepSeek-V2 论文:MLA 与低秩 KV 压缩。
- DeepSeekMoE 论文:细粒度专家和共享专家。
- DeepSeekMath 论文:GRPO 的原理与目标函数。
- DeepSeek-R1 首发公告:发布时间、开放策略与历史 API 定价。
- Hugging Face Open-R1:首发开放范围与社区复现行动。